La corsa globale all'intelligenza artificiale viene solitamente misurata in processori, potenza di calcolo e modelli linguistici di grandi dimensioni sempre più capaci. Tuttavia, la Cina potrebbe possedere un altro vantaggio molto più difficile da riprodurre: enormi quantità di dati industriali del mondo reale.
Un rapporto pubblicato il 18 agosto dalla U.S.-China Economic and Security Review Commission sostiene che la Cina stia trattando sistematicamente i dati come una risorsa nazionale strategica, convertendo le informazioni generate dalla produzione, dalla robotica e dalle operazioni industriali in un vantaggio per l'intelligenza artificiale.
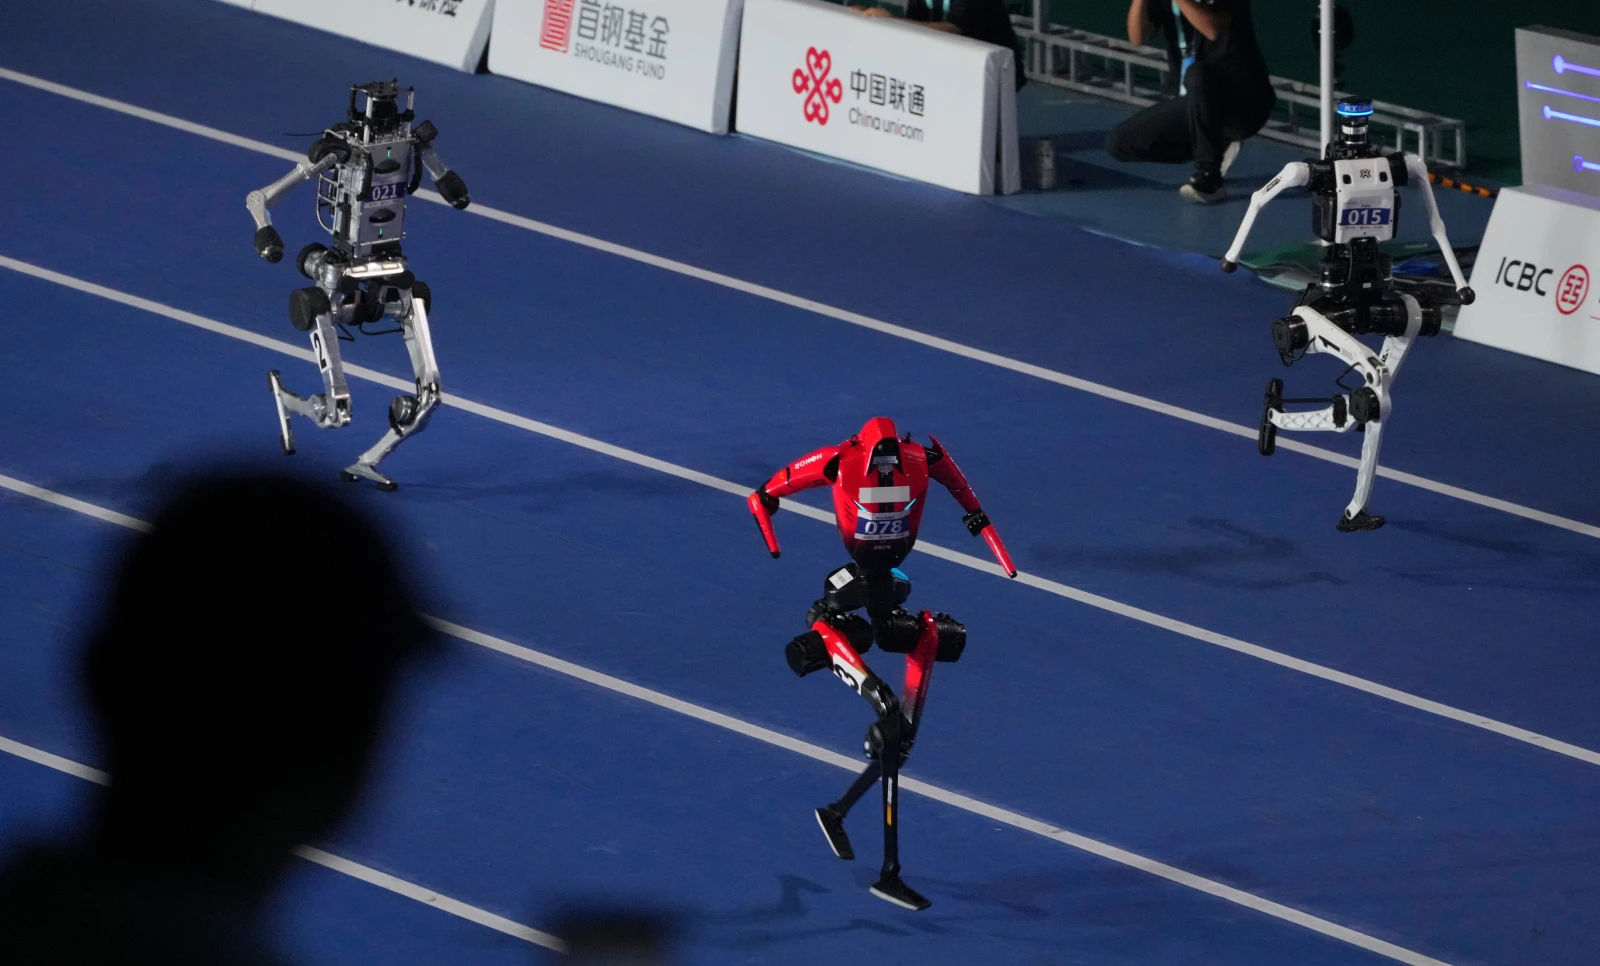
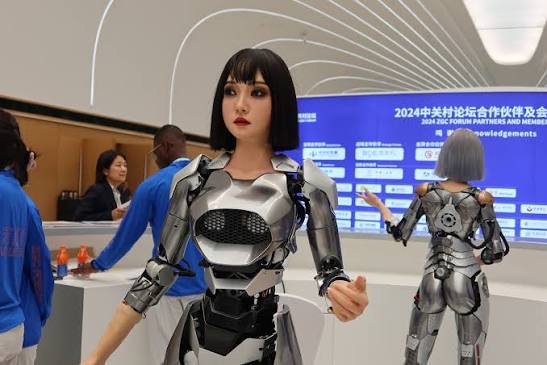
Questo aspetto è particolarmente rilevante per la cosiddetta "embodied AI" — l'intelligenza artificiale che opera attraverso robot, veicoli autonomi e altre macchine. Un modello linguistico può apprendere da documenti e siti web. Un robot, invece, deve imparare cosa accade quando afferra un oggetto in modo errato, incontra un ostacolo imprevisto, lavora accanto agli esseri umani o manipola migliaia di componenti con forme e pesi differenti.
Il vasto settore manifatturiero cinese fornisce un ambiente di addestramento straordinario.
Ogni robot impiegato in un impianto automobilistico, in una fabbrica di elettronica o in un magazzino può potenzialmente generare informazioni su movimento, visione, forza, posizionamento e guasti. Quando tali set di dati vengono raccolti e perfezionati su migliaia di macchine, l'impiego industriale stesso diventa parte del processo di sviluppo dell'IA. La commissione statunitense descrive questa interazione tra il dominio manifatturiero della Cina e il suo ecosistema IA aperto come un vantaggio potenzialmente auto-rinforzante.
Il processo somiglia allo sviluppo della guida autonoma. Milioni di chilometri percorsi forniscono situazioni insolite che non possono essere facilmente ricreate in laboratorio. Nella robotica industriale, milioni di operazioni fisiche ripetute possono allo stesso modo insegnare all'IA come si comporta il mondo reale.
Pechino ha inoltre costruito un'infrastruttura istituzionale attorno ai dati. La Cina ha creato la National Data Administration nel 2023 e ha promosso scambi di dati regionali, la standardizzazione e il commercio di dataset. L'obiettivo è trasformare sempre più le informazioni sparse tra aziende e istituzioni pubbliche in una risorsa economicamente utilizzabile.
Questo potrebbe aiutare a compensare uno dei maggiori svantaggi tecnologici della Cina: l'accesso limitato ai più avanzati processori IA occidentali. La potenza di calcolo rimane di fondamentale importanza, ma dataset superiori o specializzati possono migliorare i modelli senza fare affidamento esclusivamente su cluster di calcolo sempre più grandi.
L'ecosistema IA open-weight cinese, sempre più influente, aggiunge un'altra dimensione. I modelli possono essere distribuiti ampiamente in tutte le fabbriche e in altri settori, generando informazioni aggiuntive in grado di alimentare le future generazioni di software.
Esistono preoccupazioni significative riguardanti la privacy, la riservatezza aziendale, l'accesso da parte dello Stato e le applicazioni militari dei dataset industriali. La commissione americana inquadra esplicitamente la strategia cinese sui dati come una questione strategica e di sicurezza, piuttosto che come un semplice sviluppo commerciale.
Tuttavia, il significato tecnologico è chiaro. La prossima svolta nell'IA potrebbe non derivare solo dalla costruzione di un centro dati più grande.
Potrebbe derivare dalla connessione dell'intelligenza artificiale a milioni di macchine che operano ogni giorno nell'economia fisica.
In tal caso, le fabbriche cinesi potrebbero diventare qualcosa di più di semplici centri di produzione. Potrebbero diventare alcuni dei più grandi laboratori di addestramento per l'IA al mondo.