Das globale Rennen um die künstliche Intelligenz wird gewöhnlich an Prozessoren, Rechenleistung und immer leistungsfähigeren großen Sprachmodellen gemessen. Doch China könnte über einen weiteren Vorteil verfügen, der weitaus schwerer zu reproduzieren ist: enorme Mengen an industriellen Realdaten.
Ein am 18. August von der U.S.-China Economic and Security Review Commission veröffentlichter Bericht argumentiert, dass China Daten systematisch als strategische nationale Ressource behandelt und Informationen aus der Fertigung, Robotik und industriellen Abläufen in einen Vorteil für künstliche Intelligenz umwandelt.
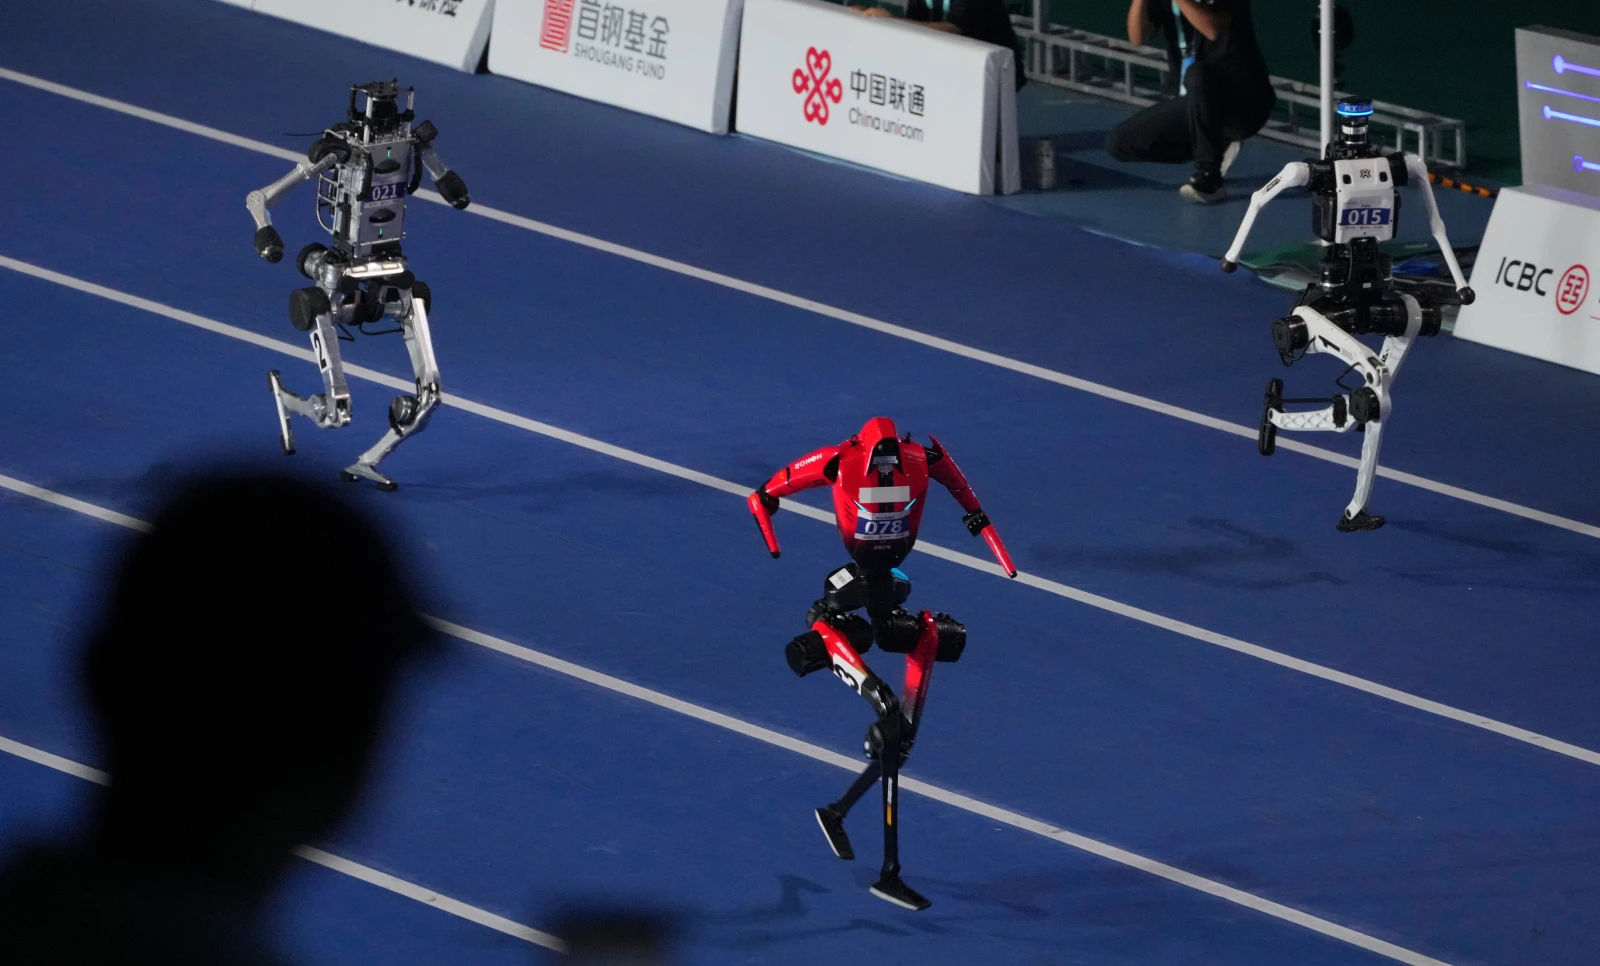
Dies ist besonders wichtig für die sogenannte „Embodied AI“ – künstliche Intelligenz, die über Roboter, autonome Fahrzeuge und andere Maschinen agiert. Ein Sprachmodell kann aus Dokumenten und Websites lernen. Ein Roboter hingegen muss lernen, was passiert, wenn er ein Objekt falsch greift, auf ein unerwartetes Hindernis stößt, neben Menschen arbeitet oder Tausende von Komponenten mit unterschiedlichen Formen und Gewichten manipuliert.
Chinas riesiger Fertigungssektor bietet eine außergewöhnliche Trainingsumgebung.
Jeder Roboter, der in einem Automobilwerk, einer Elektronikfabrik oder einem Lagerhaus eingesetzt wird, kann potenziell Informationen über Bewegung, Sicht, Kraft, Positionierung und Fehler generieren. Wenn solche Datensätze über Tausende von Maschinen hinweg gesammelt und verfeinert werden, wird der industrielle Einsatz selbst zu einem Teil des KI-Entwicklungsprozesses. Die US-Kommission beschreibt diese Interaktion zwischen Chinas Dominanz in der Fertigung und seinem offenen KI-Ökosystem als einen potenziell selbstverstärkenden Vorteil.
Der Prozess ähnelt der Entwicklung des autonomen Fahrens. Millionen gefahrener Kilometer liefern ungewöhnliche Situationen, die in Laboren nicht ohne Weiteres nachgestellt werden können. In der Industrierobotik können Millionen wiederholter physischer Operationen der KI gleichermaßen beibringen, wie sich die reale Welt verhält.
Peking hat zudem eine institutionelle Infrastruktur rund um Daten aufgebaut. China gründete 2023 die National Data Administration und hat regionale Datenaustausche, Standardisierung und den kommerziellen Handel mit Datensätzen gefördert. Ziel ist es zunehmend, über Unternehmen und öffentliche Institutionen verstreute Informationen in eine wirtschaftlich nutzbare Ressource zu verwandeln.
Dies könnte helfen, einen der größten technologischen Nachteile Chinas auszugleichen: den eingeschränkten Zugang zu den fortschrittlichsten westlichen KI-Prozessoren. Rechenleistung bleibt zwar von entscheidender Bedeutung, aber überlegene oder spezialisierte Datensätze können Modelle verbessern, ohne ausschließlich auf immer größere Rechencluster angewiesen zu sein.
Chinas zunehmend einflussreiches Open-Weight-KI-Ökosystem fügt eine weitere Dimension hinzu. Modelle können flächendeckend in Fabriken und anderen Industriezweigen eingesetzt werden und dabei zusätzliche Informationen generieren, die in künftige Softwaregenerationen einfließen.
Es bestehen erhebliche Bedenken hinsichtlich des Datenschutzes, der Unternehmensvertraulichkeit, des staatlichen Zugriffs und der militärischen Anwendung industrieller Datensätze. Die amerikanische Kommission stuft Chinas Datenstrategie explizit als Strategie- und Sicherheitsfrage ein und nicht bloß als kommerzielle Entwicklung.
Dennoch ist die technologische Bedeutung klar. Der nächste KI-Durchbruch könnte nicht allein durch den Bau eines größeren Rechenzentrums erfolgen.
Er könnte daraus resultieren, künstliche Intelligenz mit Millionen von Maschinen zu vernetzen, die täglich in der physischen Wirtschaft arbeiten.
Sollte dies der Fall sein, könnten Chinas Fabriken zu mehr als nur Produktionsstätten werden. Sie könnten sich zu einigen der weltweit größten KI-Trainingslabore entwickeln.