A globális mesterségesintelligencia-versenyt általában processzorokban, számítási kapacitásban és az egyre fejlettebb nagy nyelvi modellekben mérik. Kína azonban rendelkezhet egy másik, sokkal nehezebben reprodukálható előnnyel: hatalmas mennyiségű valós ipari adattal.
Az U.S.-China Economic and Security Review Commission augusztus 18-án közzétett jelentése szerint Kína szisztematikusan stratégiai nemzeti erőforrásként kezeli az adatokat, és a gyártás, a robotika, valamint az ipari műveletek során keletkező információkat a mesterséges intelligencia fejlesztésének szolgálatába állítja.
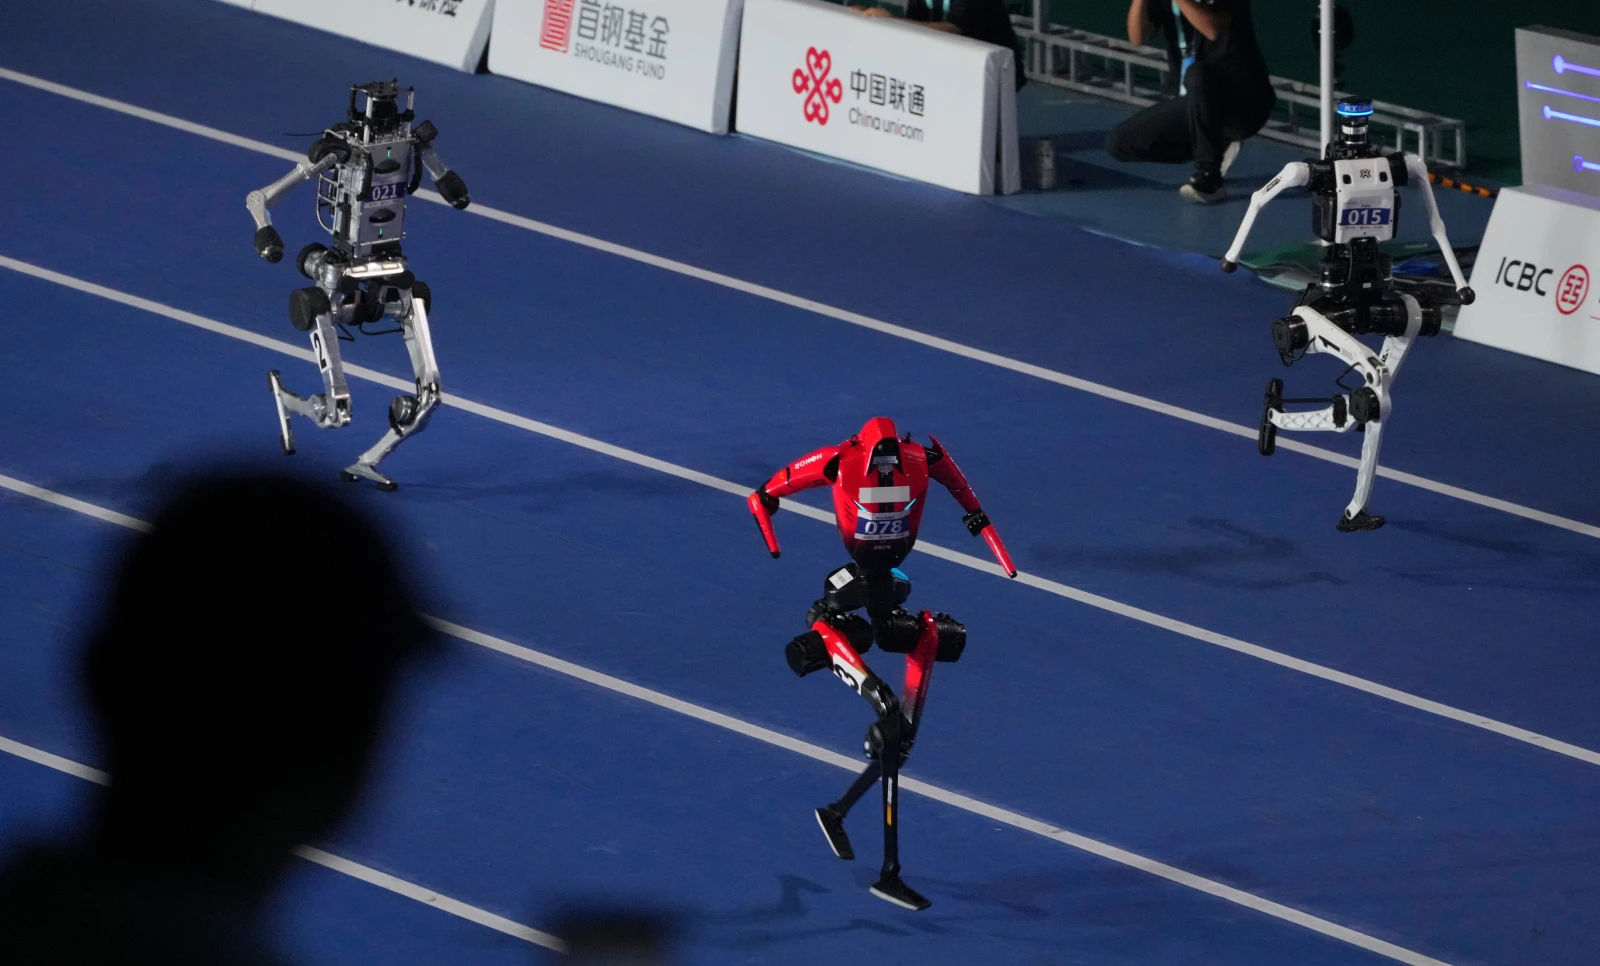
Ez különösen a „testet öltött AI” (embodied AI) esetében fontos — vagyis a robotokon, önvezető járműveken és egyéb gépeken keresztül működő mesterséges intelligenciánál. Egy nyelvi modell tanulhat dokumentumokból és weboldalakról, de egy robotnak meg kell tanulnia, mi történik, ha helytelenül fog meg egy tárgyat, váratlan akadályba ütközik, emberek mellett dolgozik, vagy több ezer különböző alakú és súlyú alkatrészt mozgat.
Kína hatalmas gyártási szektora rendkívüli környezetet biztosít a betanításhoz.
Minden egyes autógyárban, elektronikai üzemben vagy raktárban üzembe helyezett robot potenciálisan információt generál a mozgásról, látásról, erőkifejtésről, pozicionálásról és a meghibásodásokról. Amikor ezeket az adatsorokat gépek ezreitől gyűjtik be és finomítják, maga az ipari alkalmazás válik az AI-fejlesztési folyamat részévé. Az amerikai bizottság szerint Kína gyártási dominanciája és nyitott AI-ökoszisztémája közötti kölcsönhatás egy potenciálisan önmagát erősítő előnyt hoz létre.
A folyamat az önvezető technológia fejlesztéséhez hasonlít. A levezetett kilométerek milliói olyan ritka helyzeteket produkálnak, amelyeket laboratóriumi körülmények között nem lehet könnyen előállítani. Az ipari robotikában a több millió ismétlődő fizikai művelet hasonló módon taníthatja meg az AI-nak, hogyan viselkedik a való világ.
Peking intézményi infrastruktúrát is kiépített az adatok köré. Kína 2023-ban létrehozta a National Data Administration-t, és ösztönözte a regionális adatcseréket, a szabványosítást, valamint az adatkészletek kereskedelmi forgalmazását. A cél egyértelműen az, hogy a vállalatoknál és közintézményeknél elszórtan jelen lévő információkat gazdaságilag hasznosítható erőforrássá alakítsák.
Ez segíthet kompenzálni Kína egyik legnagyobb technológiai hátrányát: a legfejlettebb nyugati AI-processzorokhoz való korlátozott hozzáférést. A számítási teljesítmény továbbra is kritikus fontosságú, de a kiváló minőségű vagy speciális adatkészletek javíthatják a modelleket anélkül is, hogy kizárólag egyre nagyobb számítási klaszterekre kellene támaszkodniuk.
Kína egyre befolyásosabb, nyílt forráskódú (open-weight) AI-ökoszisztémája újabb dimenziót ad a kérdéshez. A modelleket széles körben alkalmazhatják a gyárakban és más iparágakban, további információkat generálva, amelyek a szoftverek következő generációit táplálhatják.
Ugyanakkor komoly aggályok merülnek fel a magánélet védelmével, a vállalati titoktartással, az állami hozzáféréssel és az ipari adatkészletek katonai felhasználásával kapcsolatban. Az amerikai bizottság kifejezetten stratégiai és biztonsági kérdésként, nem pedig pusztán kereskedelmi fejlesztésként keretezi Kína adatstratégiáját.
A technológiai jelentőség mindenesetre egyértelmű. A következő AI-áttörés nem biztos, hogy csak egy nagyobb adatközpont megépítéséből fakad majd.
Sokkal inkább abból, hogy a mesterséges intelligenciát összekapcsolják a fizikai gazdaságban nap mint nap működő gépek millióival.
Ha ez így van, a kínai gyárak többé válhatnak egyszerű gyártási központoknál. A világ legnagyobb AI-betanító laboratóriumaivá alakulhatnak át.